
⬆️ 點上方縮圖或影片連結即可播放。
文章一多,列表很快就翻不完:該用分頁、無限滾動,還是加一個搜尋框?
分頁與無限滾動都在處理列表太長:把列表切開或分段載入。它們解決不了「我知道我要找哪一篇,只是翻不到」這件事。目標明確時,使用者需要的是直接跳到那篇文章。接下來做一個打字就能即時篩選的搜尋框,也加入標籤篩選。(分頁本身是個獨立題目,Day 16:分頁與轉址會專門講。)
做了搜尋後,還得決定它在哪裡執行:由 Astro 在 build 時先處理,還是交給瀏覽器?分工錯了,可能查不到資料,也可能把整包文章送進使用者的瀏覽器。
查詢歸伺服器,過濾歸瀏覽器。
判準是「這件事要做幾次」:
兩種工作的執行次數不同,build 時與瀏覽器端的分工也不同。
有個很直覺的想法:既然要搜尋,讓島自己去 getCollection 拿資料不就好了?
getCollection 無法在瀏覽器執行。它是 build/server 端的 API,會讀取 Astro 的內容層;瀏覽器沒有這個能力。
這就是 islands 架構的邊界。官方文件這樣說明 island props 的限制:
Props that are passed to interactive framework components (using a
client:*directive) must be serialized.
Passing functions to hydrated components is not supported.
server 與 client 之間只能傳可序列化的資料,例如字串、數字、陣列與物件。函式不能跨過這條線,因此要先在伺服器這側查好,再把結果送到 client。
版本基準(2026-07-21 查證):本篇用到的
getCollection、render()、client:*指令與 props 序列化規則都在 Astro v5 定案,v6、v7 沿用,沒有破壞性變更;實作版本為 v7.1.1。v4 的過期寫法列在下面的「容易誤會的地方」。
先做列表頁。重點全在 frontmatter 那幾行:
---
// src/pages/blog/index.astro
import { getCollection } from 'astro:content';
import BaseLayout from '../../layouts/BaseLayout.astro';
import SearchFilter from '../../components/SearchFilter.vue';

export const prerender = true;

// 查一次:build 當下查全部、濾掉草稿、排好序。所有訪客共用這份結果。
const posts = (await getCollection('blog', ({ data }) => !data.draft))
  .sort((a, b) => a.data.day - b.data.day)
  // 只挑島內用得到的欄位再傳下去。
  .map((post) => ({
    id: post.id,
    title: post.data.title,
    description: post.data.description,
    day: post.data.day,
    tags: post.data.tags,
  }));
---

<SearchFilter posts={posts} client:load />
這段程式分成三個部分:
getCollection 的第二個參數是過濾函式。 回傳 true 的才留下。這裡用它濾掉 draft: true 的草稿,讓沒寫完的文章不會流到前端。
排序要自行指定。 官方文件對 collection 的產出順序有明確說明:
The sort order of generated collections is non-deterministic and platform-dependent.
如果不排序,產出順序不固定,換台機器也可能不同。這裡依鐵人賽的 day 升冪排;一般部落格通常是 pubDate 降冪。
.map() 決定哪些欄位會送進使用者的瀏覽器,也直接影響頁面大小。
島收到純資料後,依照使用者當下的輸入算出該顯示哪幾篇:
<script setup lang="ts">
// src/components/SearchFilter.vue
import { computed, ref } from 'vue'

// 只宣告島內真的用得到的欄位——沒有 body、沒有整包 entry。
type Post = {
  id: string
  title: string
  description: string
  day: number
  tags: string[]
}

const { posts } = defineProps<{ posts: Post[] }>()

const query = ref('')
const activeTag = ref('')

// 全站標籤去重清單。純資料處理,跟框架無關。
const allTags = computed(() => [...new Set(posts.flatMap((post) => post.tags))].sort())

const filtered = computed(() => {
  const keyword = query.value.trim().toLowerCase()
  return posts.filter((post) => {
    if (activeTag.value && !post.tags.includes(activeTag.value)) return false
    if (!keyword) return true
    return (
      post.title.toLowerCase().includes(keyword) ||
      post.description.toLowerCase().includes(keyword)
    )
  })
})
</script>
這份實作不需要 fetch、getCollection 或其他請求。資料在頁面載入時就已經在手上,篩選只是在記憶體裡做陣列運算,所以打字時能即時反應。
標籤清單由資料算出,不必另外維護設定:flatMap 把每篇的標籤攤平、Set 去重、sort 排序。這段純資料處理不依賴 Vue 或 Astro,換到其他語言仍然成立。
回到剛才那段 .map()。既然資料都要送,為什麼不整包送過去比較省事?
island 的 props 會被序列化,寫進 HTML 後送給每一個訪客。送得越多,頁面越大。
打開產出的 HTML 就能檢查。Astro 把 props 放在 <astro-island> 標籤上:
<astro-island props="{"posts":[1,[[0,{"id":[0,"day-01-why-astro"],
"title":[0,"已經會 React/Vue,為什麼還要看 Astro?"],…
裡面就是那五個欄位,文章正文一個字都沒有。
同一個頁面、同一座島,只改 .map() 裡送什麼,量到的結果如下:
| 傳法 | /blog/index.html 大小 |
|---|---|
| 只挑 5 個欄位(id / title / description / day / tags) | 30,140 bytes |
整包 ...post.data 再加 body |
161,300 bytes |
差 131,160 bytes,也就是 5.4 倍。這還只有 13 篇文章;差距會隨文章數線性放大,寫到 100 篇時也會等比例增加。
要驗證就改 .map() 的內容、跑 npm run build,再量 dist/ 裡那支 HTML 的大小。
只傳島內會用到的欄位。這座島用到的只有 id、標題、描述、標籤與 Day 編號,所以只送這五個欄位。body 送過去完全用不到,卻會增加每個訪客的下載量。
client: 指令接著要決定這座島何時啟動。三個指令的差別在 hydration 時機:
| 指令 | 什麼時候 hydrate | 適合 |
|---|---|---|
client:load |
頁面一載入就啟動 | 首屏可見、使用者隨時可能互動 |
client:idle |
等瀏覽器空檔(requestIdleCallback) |
首屏但不急的次要功能 |
client:visible |
捲到它進入畫面才啟動 | 在摺線以下、或載入成本高 |
三個指令都在取捨互動的即時性與首屏 JS 成本。
搜尋框位於頁面上方,使用者很可能一進頁就開始打字,因此選 client:load。島還沒 hydrate 時,輸入不會篩出結果;對這個位置的功能來說,互動延遲不值得拿幾 KB 的首屏 JS 來換。
反過來,如果你的篩選器放在頁面很下面,client:visible 就合理:使用者沒捲到那裡,這段 JS 根本不用載。
以下三個狀態用的是同一份資料:
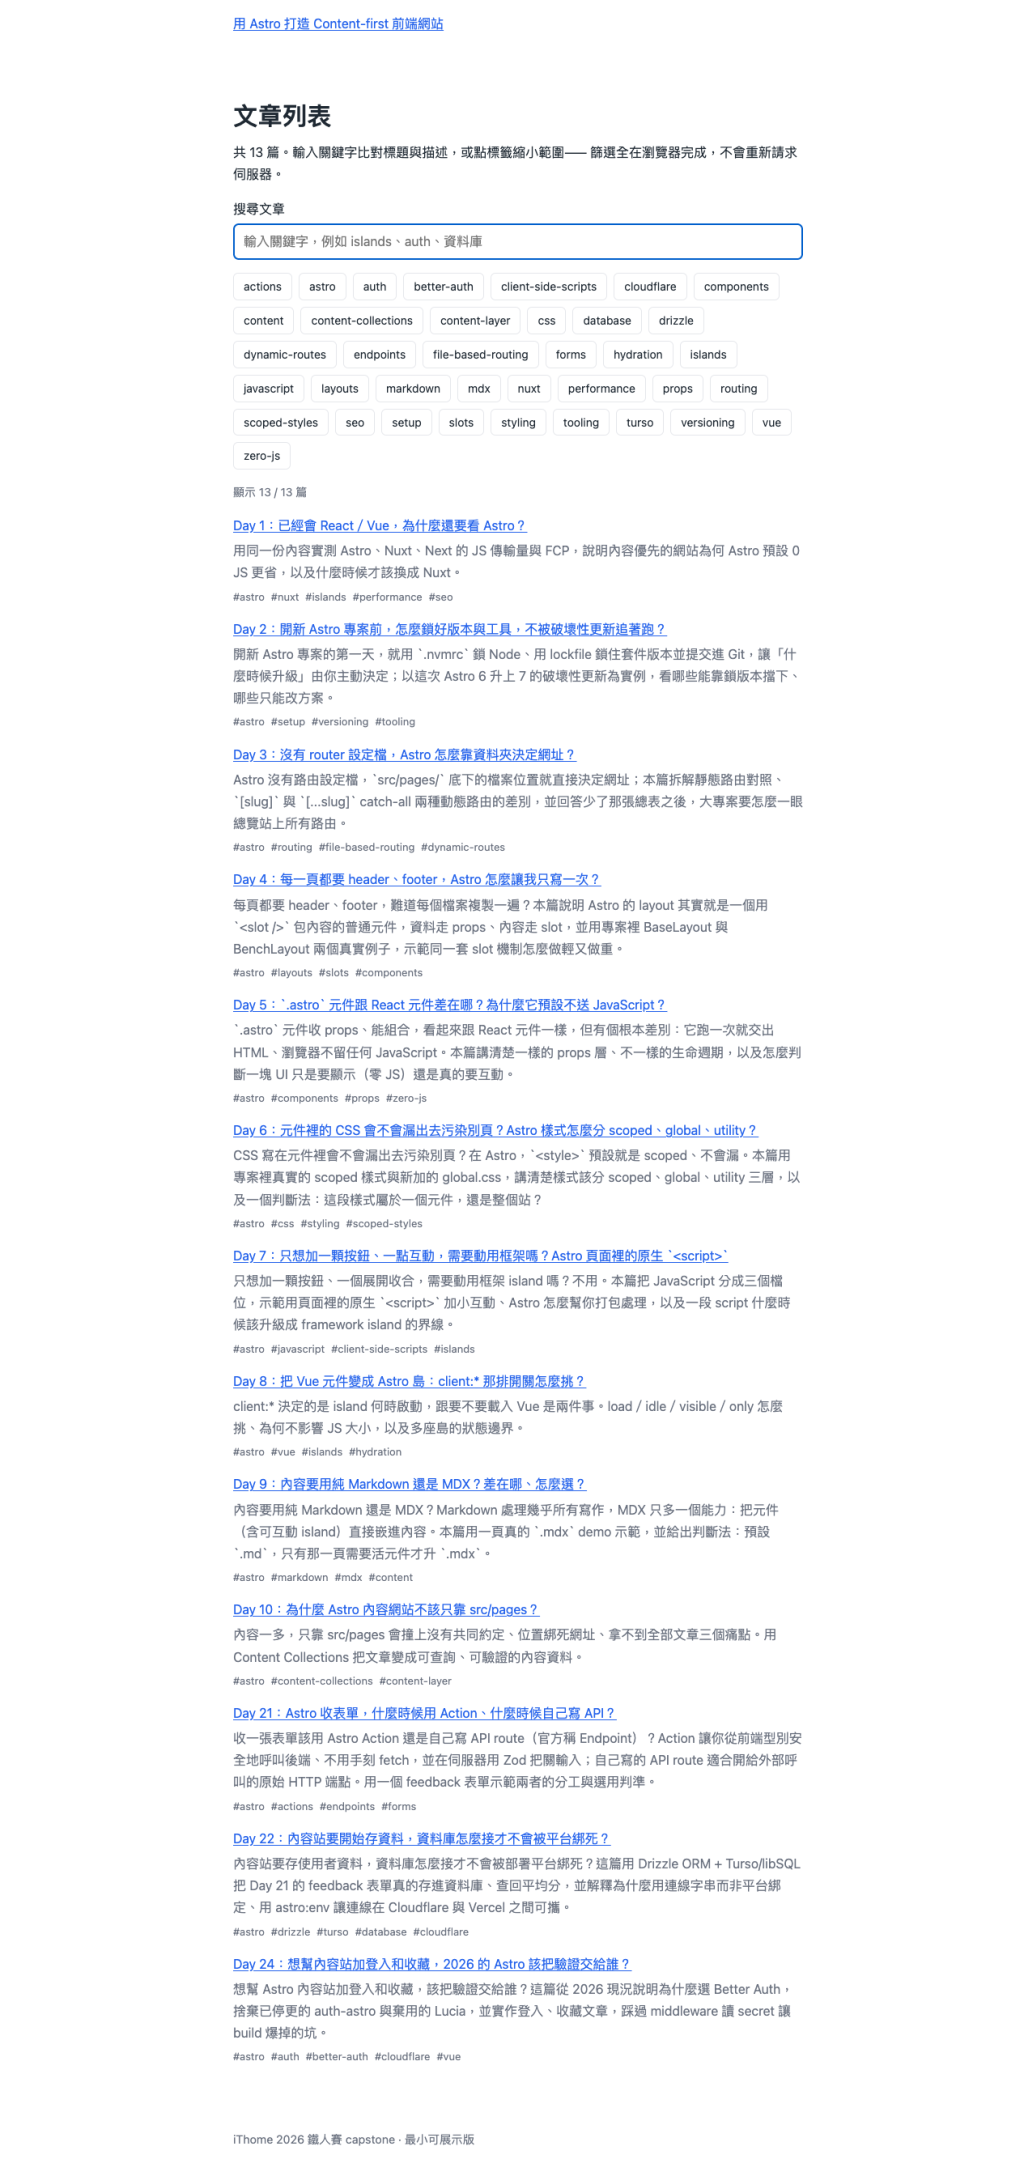
初始狀態,13 篇全列出來:
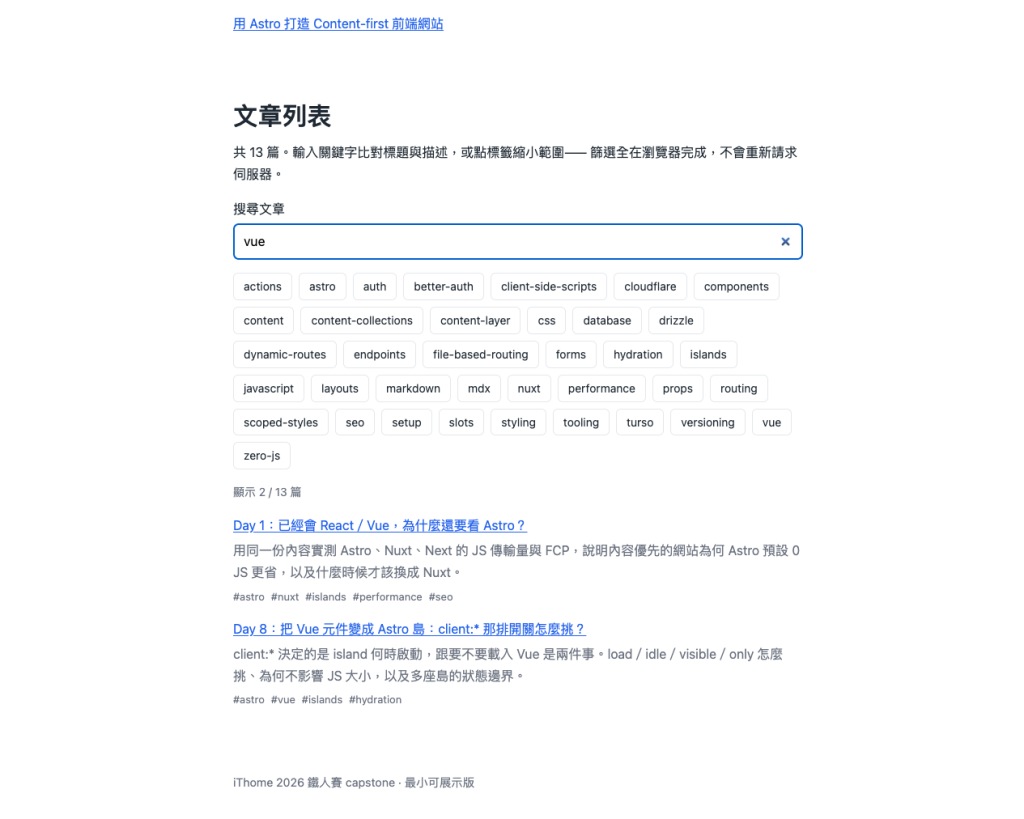
在搜尋框打 vue,列表當場縮到 2 篇:
改點 islands 標籤,篩出 3 篇:
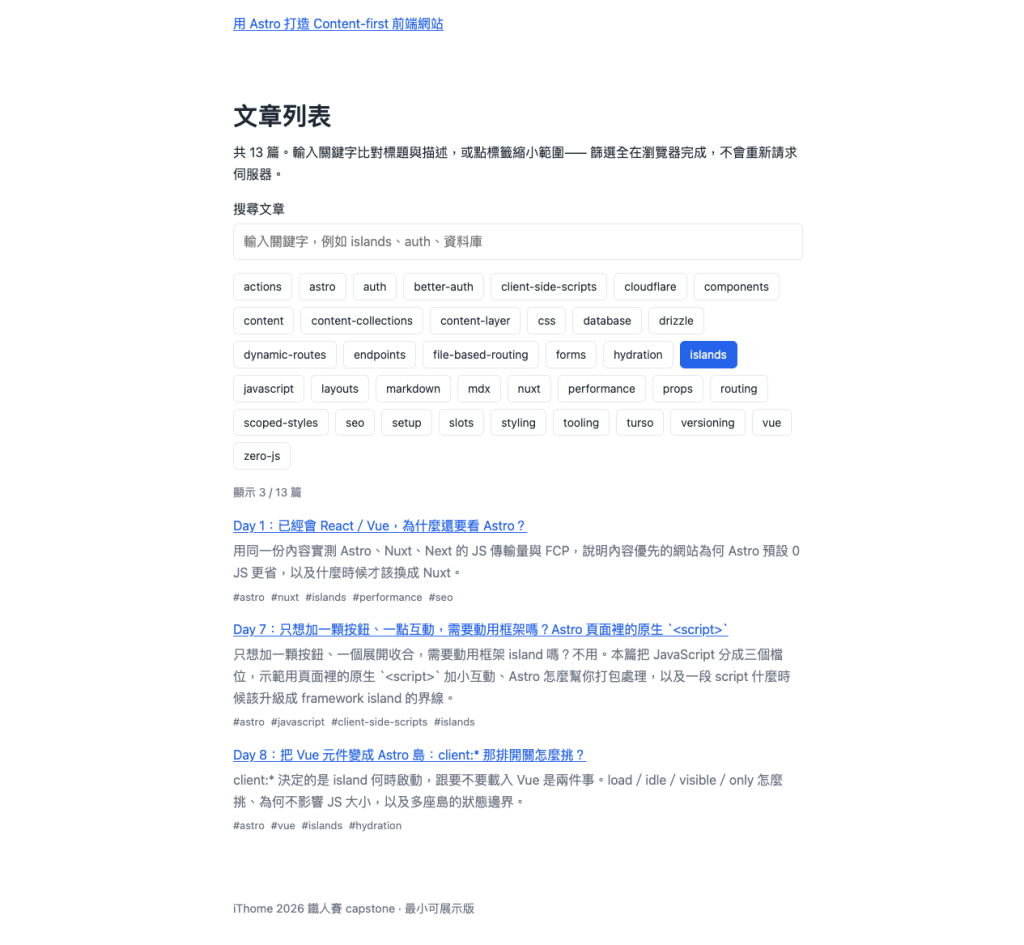
三張畫面之間沒有網路請求,也沒有換頁。build 時備好的同一份資料,在瀏覽器裡反覆篩出不同結果。
前端篩選有適用條件,搜尋不必一律放在前端。
沒有通用答案,分工要看專案條件。後端已經有搜尋 API 時,不必在前端重做;列表原本就會把全部資料送進瀏覽器時,為了搜尋多打一支 API 反而多餘。直接照抄別人的架構,往往會忽略這些差異。
最常用的判準是:這份資料本來就要全部送到前端嗎?
本篇的 Astro 內容站屬於前者:文章清單本來就會完整列出,資料已經在頁面上,搜尋只是換個方式呈現同一份資料。
「一次塞大量資料」是這種做法的上限。前面的 5.4 倍顯示:程式不會因此壞掉,但頁面會隨資料增加而變重。需要持續檢查資料筆數,以及每筆送出的欄位。
前面的實作只比對 metadata,也就是 title 和 description,因為只送了這兩段文字。若要搜尋文章內文,就不能把索引整包塞進 payload,否則會遇到前面量出的 5.4 倍差距。
先回答兩個問題。
第一條:要不要全文? 不需要全文時,前面的 metadata 比對就足夠;需要時,再看第二條。
第二條:內容在 build 時就定了嗎?
如果是(部落格、文件站這類內容站),可以用 Pagefind。它不讀原始碼,而是在 build 之後掃描產出的 HTML 來建索引,用分片處理前面量到的 payload 問題:
Pagefind's search index is split into chunks, so that searching in the browser only ever needs to load a small subset of the search index.
Pagefind 將索引分片,瀏覽器只載需要的那一小塊,每筆結果的資料則逐筆抓取。官方給的數字是 10,000 頁的站,全文搜尋總傳輸量在 300kB 以下。對照這篇量到的「13 篇、整包送 body 就 161KB」,兩者的差別在於索引是否分片。Astro 的文件框架 Starlight 預設就是用它,不需要任何設定。
但它有一條硬限制:
Pagefind cannot be enabled when the
prerenderoption is set tofalse.
(Starlight site search、Pagefind)
Pagefind 只讀 build 產出的靜態 HTML。SSR 或 on-demand 的頁面在 build 當下還不存在,因此無法進入索引。這是由產出方式決定的限制。
反過來,如果內容在 build 時還不確定(使用者產生的內容、要即時更新、要跟會員或收藏資料 join),就得進資料庫。這個系列的 capstone 使用 Turso,而 SQLite 的 FTS5 全文搜尋在 Turso 上是預載好的擴充,不用另外裝。
第三種選項是把搜尋交給託管服務。Algolia 的 DocSearch 對開發者文件與技術部落格免費,Starlight 也有官方 plugin 可以換上它。免費方案要先通過資格審查(官方列出的常見婉拒理由是網站還沒 production ready、或含有非技術性內容),核准後七天內要完成網域驗證,搜尋結果旁也必須保留它的 logo。不接受這些條件,就得自己開 Algolia 帳號。
| 方案 | 全文? | 索引放哪 | 適合 |
|---|---|---|---|
| 手刻前端篩選(這篇) | 只比 metadata | 序列化進 HTML,隨頁面下載 | 數十篇、metadata 夠用 |
| Pagefind | 是 | build 後掃 HTML,分片按需下載 | 內容在 build 時就定的靜態站 |
| 資料庫全文搜尋(如 Turso FTS5) | 是 | 資料庫,前端零索引 | 內容會變、要跟使用者資料 join |
| Algolia DocSearch | 是 | 第三方託管 | 不想自己維護 relevance 與 UI |
查證註記(2026-07-21):Astro 官方文件目前沒有搜尋專章,搜尋屬於「核心不管、交給 Starlight 與社群」的範圍;
astro-pagefind是社群專案,不是官方維護。Astro 官方文件站也關掉了 Pagefind、改用 Algolia DocSearch。方案仍要依站點性質與使用條件決定。
entry.render() 和 entry.slug 已移除。 現在渲染是 import { render } from 'astro:content' 再 await render(entry);識別欄位是 entry.id,不是 slug。這兩個都在 v5 移除,但網路上仍有大量停在 v4 的教學。看到 .render()、.slug、type: 'content',代表內容使用的是舊 API。title 和 description,因為只送了這兩段文字。若要全文搜尋,請沿上一節的兩條分界線選方案。prerender = true 不影響搜尋。 有人會擔心靜態頁是不是就不能有互動。列表頁確實是 build 時就產好的靜態 HTML,但島的 JS 照樣會送到瀏覽器、照樣會 hydrate。靜態的是資料,不是互動。.map() 出來的物件要能序列化。 純資料沒問題;如果不小心把函式或類別實例放進去,會在序列化那關失敗。列表頁在 build 時查詢、排序並挑出必要欄位,再把結果交給島反覆篩選。getCollection 的簽名會變,但 server/client 的分界不依賴單一 API:查詢在伺服器、互動在瀏覽器,中間只能傳可序列化的資料。
「送什麼進島」可以直接量測。這篇的 5.4 倍差距只改了一行 .map();遇到同類決定,先量輸出再選欄位。
Day 15 會從 /blog/day-01-why-astro 這類網址出發,說明動態路由與 getStaticPaths(),再區分哪些頁面在 build 時產生、哪些要等請求進來。SSG 與 SSR 的分界,延續的是這篇「查一次 vs 篩無數次」的判斷方式。
本日程式碼:step-14|只看這天的改動:step-13...step-14


 iThome鐵人賽
 看影片追技術